مدلهای هوش مصنوعی چگونه میآموزند؟
عصمتالله جعفری
مدلهای هوش مصنوعی چگونه یاد میگیرند، تجربه کسب میکنند و از عهده وظایف مختلف برمیآیند؟ در این یادداشت کوتاه، نگاهی ساده و گذرا به شیوههای یادگیری مدلهای هوش مصنوعی خواهیم داشت.
هر سیستم هوش مصنوعی، از سادهترین نمونهها مانند قابلیت تشخیص و فیلتر کردن هرزنامههای ایمیلی گرفته تا پیچیدهترین تکنولوژیها مانند ظرفیتهای هوشمند موترهای خودران، بر سه مؤلفه اصلی استوار است: دادهها، الگوریتمها یا مدلها و توان محاسباتی. اگر یک سیستم هوش مصنوعی را مانند فرآیند یادگیری یک انسان تصور کنیم (این تصور بسیار بسیار سادهانگارانه است)، دادهها همان اطلاعات و تجربیاتی هستند که فرد از طریق مطالعه، مشاهده و تعامل با محیط در طول زندهگی به دست میآورد. الگوریتمها یا مدلها شبیه مغز و شیوه تفکر انساناند که این اطلاعات را تحلیل، سازماندهی و به دانش قابل استفاده تبدیل میکنند. توان محاسباتی نیز مانند بدن و سیستم عصبی انسان است که انرژی، حافظه و توان پردازشی لازم را برای یادگیری و تصمیمگیری فراهم میکند.
همانگونه که کیفیت یادگیری یک فرد به میزان و کیفیت اطلاعات و تجربیات او، توانایی ذهنی در تحلیل اطلاعات و سلامت جسمی و عصبی او وابسته است، کارایی یک سیستم هوش مصنوعی نیز به کیفیت دادهها، قدرت یادگیری مدلها و اندازه توان محاسباتی آن بستهگی دارد.
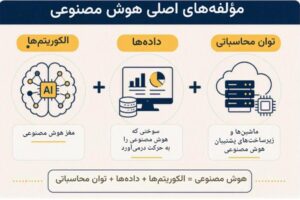
منبع: مایکروسافت (۲۰۲۴)
وقتی از «یادگیری» در هوش مصنوعی صحبت میکنیم، منظور این نیست که دادهها یا توان محاسباتی چیزی یاد میگیرند. دادهها صرفاً منبع یادگیری هستند و توان محاسباتی نیز ابزار پردازش این اطلاعات است. آنچه واقعاً یاد میگیرد، الگوریتم یا مدل است. مدل با تحلیل دادهها و استفاده از توان محاسباتی، الگوها، روابط و ویژهگیهای موجود در دادهها را شناسایی میکند و بهتدریج توانایی خود را در پیشبینی و تشخیص الگوها، روابط و ویژهگیهای مشابه در دادههای کاملاً جدید بهبود میبخشد و قابلیت انجام وظایف متفاوت را میپروراند. بنابراین، یادگیری ویژهگی مدلها یا الگوریتمهای هوش مصنوعی است؛ دادهها مواد اولیه اما حیاتی یادگیریاند و توان محاسباتی امکان پردازش آن را فراهم میکند.
شیوههای یادگیری ماشین
بهطور عموم، شیوههای یادگیری در مدلهای هوش مصنوعی به سه گروه عمده تقسیم میشود: یادگیری نظارتشده، یادگیری بدون نظارت و یادگیری تقویتی.
یادگیری نظارتشده
یادگیری نظارتشده سادهترین و محدودترین روش یادگیری ماشین است. این روش شبیه زمانی است که یک کودک در حال یادگیری نام حیوانات است و معلم یا والدین دائماً پاسخ درست را به او در طول آموزش میگویند. برای مثال، به کودک تصویری از یک گربه نشان میدهند و میگویند: «این گربه است.» سپس تصویر دیگری از یک سگ نشان میدهند و میگویند: «این سگ است.» کودک با مشاهده مثالهای متعدد و پاسخهای درست، بهتدریج یاد میگیرد که ویژهگیهای گربه و سگ را تشخیص دهد.
مدل یادگیری نظارتشده نیز به همین شکل عمل میکند. به مدل تعداد زیادی داده به همراه پاسخ صحیح داده میشود؛ برای مثال، هزاران تصویر که روی هر کدام برچسب «گربه» یا «سگ» قرار دارد. مدل با استفاده از این مثالهای برچسبگذاریشده، الگوها را میآموزد و بعداً میتواند تصاویر جدید را تشخیص دهد.
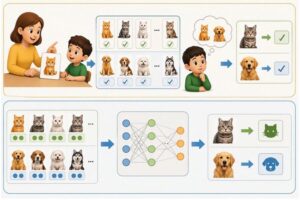
منبع: طراحی هوش مصنوعی
شاید این پرسش برایتان پیش آمده باشد که چه کسی پاسخهای صحیح را برای مدلهای هوش مصنوعی آماده میکند. پاسخ کوتاه: انسانها. اما امروزه، در کنار انسانها، مدلهای هوش مصنوعی نیز در تولید و پالایش این پاسخها سهمی فزاینده دارند؛ روشی که به آن یادگیری خودنظارتی گفته میشود.
یادگیری بدون نظارت
برخلاف یادگیری نظارتشده، در یادگیری بدون نظارت پاسخ درست در دوره آموزش به مدل داده نمیشود. چنانکه پیشتر دیدیم، در یادگیری نظارتشده، معلم یا والدین کنار کودک مینشیند، هر تصویر را به کودک نشان میدهد و نام حیوان را نیز بیان میکند: «این گربه است» و «این سگ است». بنابراین، کودک از ابتدا میداند که پاسخ درست هر تصویر چیست.
اما در یادگیری بدون نظارت، همان تصاویر بدون نام و برچسب در اختیار کودک قرار میگیرند. این بار کسی به کودک نمیگوید هر حیوان چه نامی دارد. کودک باید تصاویر را خودش بررسی کند و بر اساس شباهتها و تفاوتهای ظاهری، آنها را در گروههای مختلف قرار دهد. برای مثال، ممکن است حیواناتی را که گوشهای نوکتیز و صورت مشابه دارند در یک گروه و حیواناتی را که پوزه بلندتری دارند در گروه دیگر قرار دهد. کودک در این حالت لزوماً نمیداند نام گروه اول «گربه» و نام گروه دوم «سگ» است. کودک فقط متوجه میشود که برخی تصاویر به یکدیگر شبیهترند و احتمالاً به یک گروه تعلق دارند.
مدل یادگیری ماشین نیز در یادگیری بدون نظارت به همین شکل عمل میکند. مدل دادههای بدون برچسب را بررسی میکند و تلاش میکند شباهتها، تفاوتها، ساختارها و الگوهای پنهان میان آنها را پیدا کند.
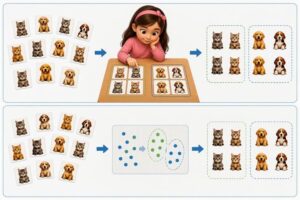
منبع: طراحی هوش مصنوعی
یادگیری تقویتی
یادگیری تقویتی را میتوان با نحوه یادگیری یک کودک هنگام دوچرخهسواری مقایسه کرد. کودک در ابتدا نمیداند چگونه تعادل خود را حفظ کند، بنابراین بارها تلاش میکند، گاهی زمین میخورد و گاهی چند متر بدون مشکل حرکت میکند. هر بار که نتیجه خوبی میگیرد، مانند حفظ تعادل یا دریافت تشویق از والدین، یاد میگیرد که آن رفتار را بیشتر تکرار کند و هر بار که نتیجه نامطلوبی میگیرد، مانند زمین خوردن، بهتدریج از آن رفتار دوری میکند.
یادگیری تقویتی در هوش مصنوعی نیز به همین شکل عمل میکند؛ یک عامل (Agent) با آزمون و خطا در محیط، برای رفتارهای موفق پاداش و برای رفتارهای ناموفق جریمه دریافت میکند و بهمرور بهترین تصمیمها را یاد میگیرد. به همین دلیل، این روش بیش از سایر شاخههای یادگیری ماشین به شیوه یادگیری انسانها و حیوانات شباهت دارد و بسیاری از ایدههای اصلی آن از نحوه یادگیری موجودات زنده الهام گرفته شدهاند.
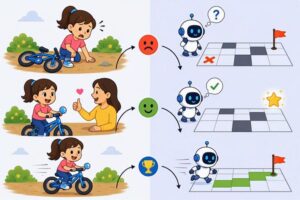
منبع: طراحی هوش مصنوعی
در این یادداشت کوشیدم نمایی کلی از روشهای یادگیری ماشین و مدلهای هوش مصنوعی ارائه دهم. البته هر یک از این حوزهها بسیار گستردهاند و مدلها، تکنیکها و روشهای گوناگونی را در بر میگیرند که برای درک و پیادهسازی آنها به دانش قابلتوجهی از ریاضیات و برنامهنویسی رایانهای نیاز است. اگر به این موضوع علاقهمند هستید، منابع فراوانی در یوتیوب و دیگر فضاهای مجازی وجود دارد که میتوانید برای یادگیری بیشتر به آنها مراجعه کنید.
امیدوارم این یادداشت یک نکته اساسی را روشن کرده باشد: همانطور که یادگیری انسان به کیفیت اطلاعات و تجربهها، توانایی ذهن برای تحلیل آنها و سلامت جسم و دستگاه عصبی وابسته است، عملکرد هوش مصنوعی نیز به کیفیت دادهها، توانایی مدل برای یادگیری و قدرت محاسباتی آن بستهگی دارد. این موضوع برای جوامعی که دادههای دیجیتال لازم و باکیفیت ندارند، اهمیت بیشتری پیدا میکند.
حتا اگر چنین دادههایی وجود داشته باشد، تفاوتهای زبانی، فرهنگی و اجتماعی ممکن است استفاده از آنها را در آموزش مدلهای هوش مصنوعی دشوار یا محدود کند. بنابراین، هرگاه زبان و تجربههای یک جامعه در دادههای آموزشی بهدرستی بازتاب نیابند، مدلهای هوش مصنوعی ممکن است تصویری ناقص، سوگیرانه یا گمراهکننده از آن جامعه ارائه دهند. افغانستان نیز از جمله جوامعی است که در فضای دیجیتال و دادههای آموزشی هوش مصنوعی بسیار محدود شامل شده است.